2. Protocolo HTTP
Cuando utilizamos una aplicación web, el cliente y el servidor necesitan unas reglas comunes para intercambiar información. En la Web, esas reglas las proporciona principalmente HTTP (Hypertext Transfer Protocol).
HTTP es un protocolo de la capa de aplicación que define cómo se construyen las peticiones que envía un cliente y las respuestas que devuelve un servidor. Aunque nació para transferir documentos de hipertexto, actualmente se utiliza también para imágenes, vídeos, archivos, APIs y comunicaciones entre aplicaciones.
HTTP sigue un modelo de petición-respuesta: el cliente inicia una petición y el servidor devuelve una respuesta.
HTTP es además un protocolo sin estado (stateless): cada petición es independiente de las anteriores. Cuando una aplicación necesita mantener información entre distintas peticiones puede utilizar mecanismos adicionales, como las cookies o los identificadores de sesión.
2.1. Cómo funciona una comunicación HTTP
El intercambio básico comienza cuando un cliente solicita un recurso o una operación a un servidor.
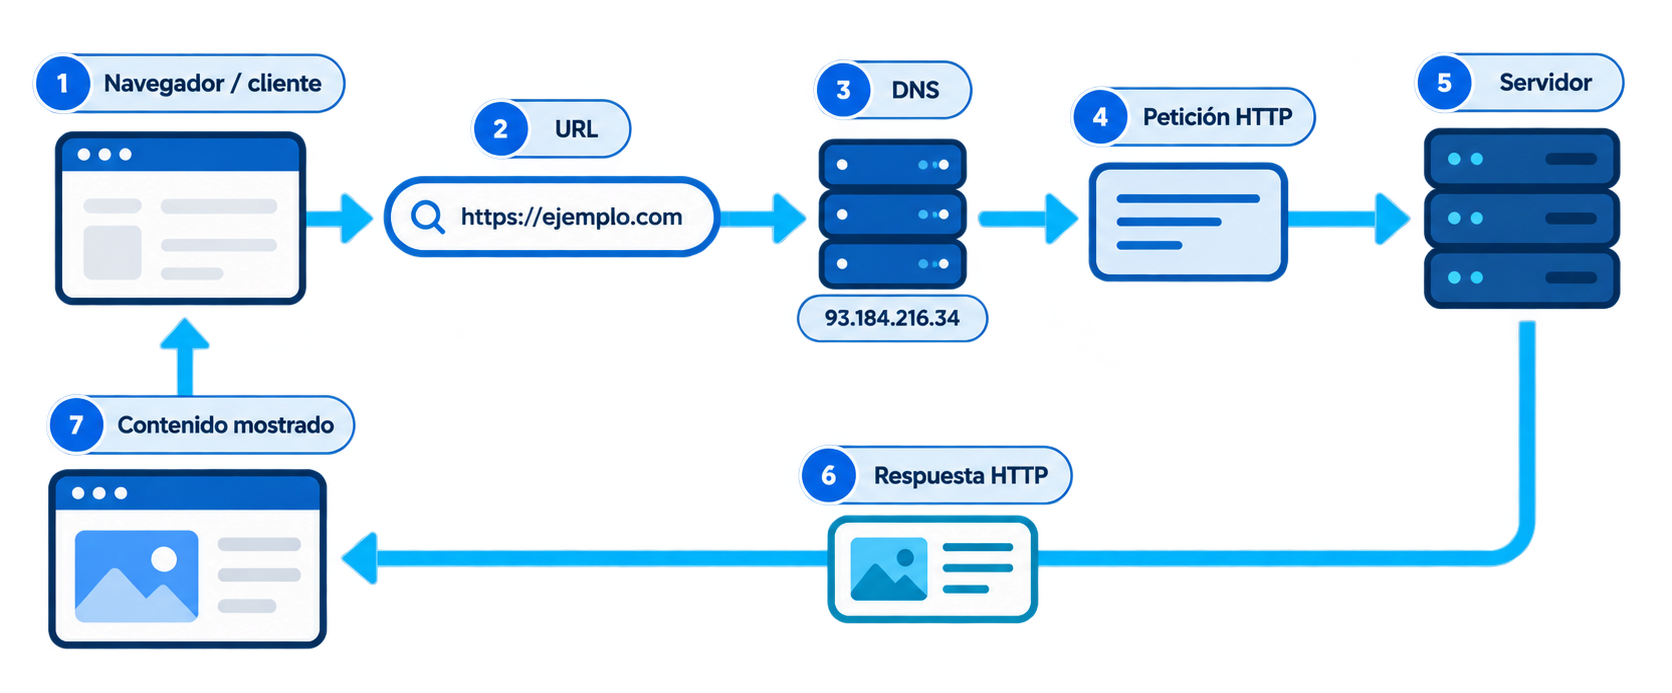
Por ejemplo, al escribir una dirección en el navegador se producen, de forma simplificada, estos pasos:
- El navegador interpreta la dirección solicitada.
- Se localiza el servidor asociado al nombre de dominio, normalmente mediante DNS.
- Se establece la comunicación necesaria con el servidor.
- El cliente envía una petición HTTP.
- El servidor procesa la petición.
- El servidor devuelve una respuesta HTTP.
- El navegador interpreta la respuesta y, si corresponde, muestra el contenido.
La URL
Para solicitar un recurso necesitamos identificarlo. En la Web utilizamos habitualmente una URL (Uniform Resource Locator).
Podemos analizar esta dirección de ejemplo:
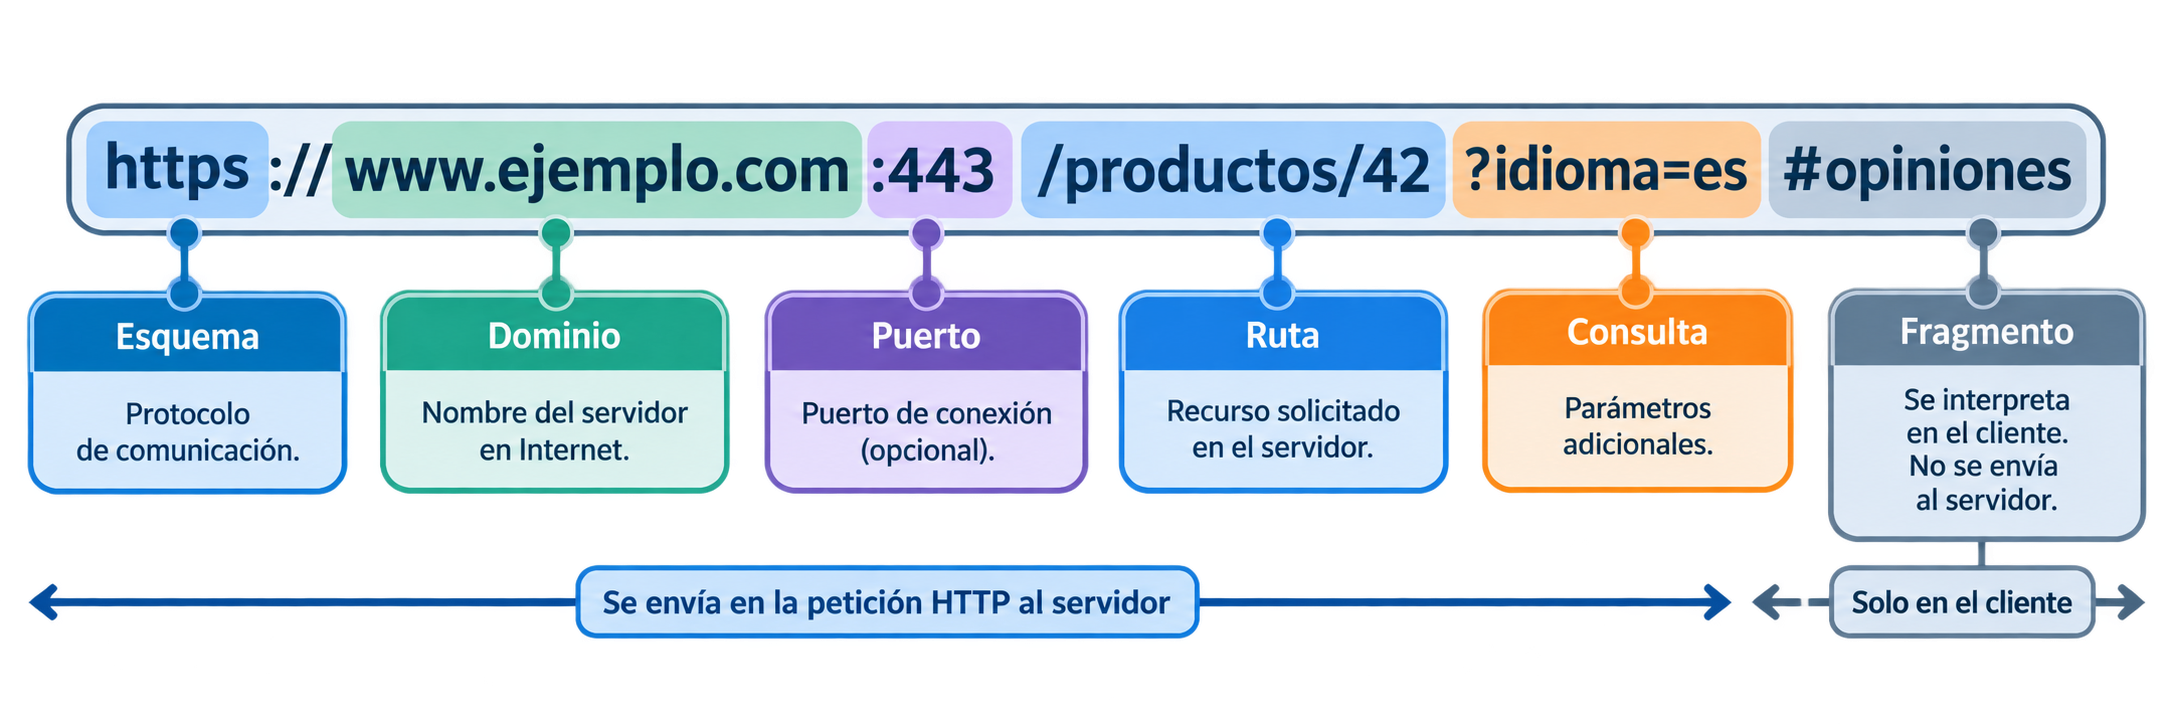
https://www.ejemplo.com:443/productos/42?idioma=es#opiniones
Sus partes principales son:
- Esquema o protocolo:
https. - Nombre del servidor o dominio:
www.ejemplo.com. - Puerto:
443. Normalmente no se escribe porque es el puerto habitual de HTTPS. - Ruta:
/productos/42. - Parámetros de consulta:
?idioma=es. - Fragmento:
#opiniones. Permite señalar una parte concreta del recurso y normalmente no se envía al servidor en la petición HTTP.
Cuando utilizamos los puertos habituales, el navegador permite omitirlos:
http://www.ejemplo.comutiliza normalmente el puerto 80.https://www.ejemplo.comutiliza normalmente el puerto 443.
Más adelante utilizaremos también el puerto 8080 con Tomcat. Es un puerto alternativo habitual para servicios HTTP, pero no es el puerto estándar de HTTP.
2.2. Peticiones HTTP
Una petición HTTP indica al servidor qué recurso queremos utilizar y qué operación queremos realizar sobre él.
Conceptualmente, una petición contiene:
- Un método HTTP.
- El recurso o ruta sobre el que actuamos.
- Información adicional en forma de cabeceras.
- En determinados métodos, un cuerpo con datos que enviamos al servidor.
Para comprender su estructura podemos observar una petición HTTP/1.1 simplificada:
GET /productos/42 HTTP/1.1
Host: www.ejemplo.com
Accept: text/html
En este ejemplo, GET indica la operación que queremos realizar, /productos/42 identifica el recurso y las líneas siguientes son cabeceras que aportan información adicional.
El formato textual resulta especialmente útil para aprender HTTP. En HTTP/2 y HTTP/3 cambia la forma en que los mensajes se codifican y transportan, pero se conservan conceptos como los métodos, las cabeceras, las URL y los códigos de estado.
Métodos HTTP
El método indica la intención de una petición. Algunos de los más habituales son:
| Método | Finalidad principal |
|---|---|
GET | Obtener una representación de un recurso. |
HEAD | Obtener las cabeceras que devolvería un GET, pero sin transferir el contenido de la respuesta. |
POST | Enviar información para que el servidor la procese. |
PUT | Crear o sustituir la representación de un recurso en la ubicación indicada. |
DELETE | Solicitar la eliminación de un recurso. |
OPTIONS | Consultar las opciones de comunicación disponibles para un recurso o servidor. |
En una navegación normal utilizaremos continuamente GET. Cuando enviamos formularios o interactuamos con una API pueden aparecer otros métodos.
Si accedemos a la ficha de un producto, el navegador puede realizar un GET. Si enviamos un formulario de registro, la aplicación puede utilizar un POST para enviar los datos al servidor.
2.3. Respuestas HTTP
Después de procesar una petición, el servidor devuelve una respuesta HTTP.
Una respuesta contiene, entre otros elementos:
- Un código de estado que indica el resultado de la petición.
- Cabeceras con información adicional.
- Opcionalmente, un cuerpo con el contenido enviado al cliente.
Un ejemplo simplificado de respuesta HTTP/1.1 sería:
HTTP/1.1 200 OK
Content-Type: text/html
Content-Length: 1250

<html>...</html>
200 indica que la petición se ha procesado correctamente. La cabecera Content-Type informa del tipo de contenido devuelto y, después de las cabeceras, encontramos el cuerpo de la respuesta.
Códigos de estado
Los códigos de estado HTTP tienen tres cifras. La primera indica la familia a la que pertenece la respuesta:
| Familia | Significado | Ejemplos |
|---|---|---|
1xx | Información provisional. | 100 Continue. |
2xx | La petición se ha procesado correctamente. | 200 OK, 201 Created, 204 No Content. |
3xx | Redirección o uso de otra representación. | 301 Moved Permanently, 302 Found, 304 Not Modified. |
4xx | El cliente ha realizado una petición que no puede satisfacerse de ese modo. | 400 Bad Request, 401 Unauthorized, 403 Forbidden, 404 Not Found. |
5xx | El servidor no ha podido completar una petición aparentemente válida. | 500 Internal Server Error, 503 Service Unavailable. |
No necesitamos memorizar todos los códigos. Es más importante reconocer las cinco familias y saber interpretar algunos códigos frecuentes.
Un 404 Not Found indica que el servidor ha respondido, pero no encuentra el recurso solicitado.
Un 500 Internal Server Error indica que el servidor ha encontrado un problema al intentar procesar la petición.
En ambos casos existe comunicación HTTP; lo que cambia es el resultado de la operación.
2.4. Cabeceras, cuerpo y seguridad
Las cabeceras HTTP permiten que cliente y servidor intercambien información adicional sobre la petición, la respuesta o el contenido transferido.
Algunos ejemplos habituales son:
Host, que identifica el servidor al que dirigimos la petición en HTTP/1.1.Accept, que informa de los tipos de contenido que el cliente puede aceptar.Content-Type, que indica el tipo del contenido enviado.Content-Length, que puede indicar el tamaño del cuerpo del mensaje.Authorization, utilizada en determinados mecanismos de autenticación.Cache-Control, que permite establecer directivas relacionadas con la caché.
El cuerpo (body) contiene los datos que acompañan al mensaje cuando son necesarios. Una respuesta puede incluir, por ejemplo, un documento HTML, una imagen o datos JSON. Una petición POST puede incluir los datos enviados desde un formulario o desde una aplicación.
2.5 HTTP y HTTPS
HTTP y HTTPS utilizan las mismas ideas fundamentales de petición, respuesta, métodos y códigos de estado. La diferencia principal es que HTTPS protege la comunicación mediante TLS.
Con HTTPS conseguimos principalmente:
- Cifrado, para dificultar que terceros puedan leer la información intercambiada.
- Integridad, para detectar modificaciones de los datos durante la comunicación.
- Autenticación del servidor, mediante certificados digitales.
Por este motivo, en la Web actual debemos utilizar HTTPS siempre que sea posible, especialmente cuando manejamos credenciales, formularios o información sensible.
El candado del navegador indica que la conexión utiliza HTTPS y que el navegador ha podido validar el certificado presentado para ese sitio. No garantiza por sí solo que el contenido o la organización responsable del sitio sean fiables.
2.6. Evolución de HTTP
HTTP nació a comienzos de la década de 1990 y ha evolucionado manteniendo prácticamente las mismas ideas fundamentales de petición y respuesta.
| Versión | Idea principal |
|---|---|
| HTTP/1.0 | Habitualmente utilizaba una conexión TCP independiente para cada intercambio petición-respuesta. |
| HTTP/1.1 | Introdujo el uso generalizado de conexiones persistentes, que permiten reutilizar una conexión para varias peticiones. |
| HTTP/2 | Mantiene la semántica de HTTP, pero utiliza un formato binario y permite multiplexar varias comunicaciones sobre una conexión TCP. |
| HTTP/3 | Mantiene las mismas semánticas HTTP, pero utiliza QUIC como transporte en lugar de TCP. QUIC funciona sobre UDP e incorpora mecanismos de fiabilidad y seguridad adecuados para HTTP. |
En explicaciones antiguas de HTTP es frecuente encontrar el proceso:
abrir conexión TCP → realizar una petición → recibir respuesta → cerrar conexión.
Ese comportamiento describe bien las primeras implementaciones y HTTP/1.0, pero no representa por sí solo el funcionamiento de la Web actual. HTTP/1.1 puede reutilizar conexiones, HTTP/2 multiplexa varias comunicaciones sobre una misma conexión TCP y HTTP/3 utiliza QUIC.
Lo que permanece estable es el modelo lógico que debemos aprender:
cliente → petición HTTP → servidor → respuesta HTTP → cliente
2.7. Observar HTTP en el navegador
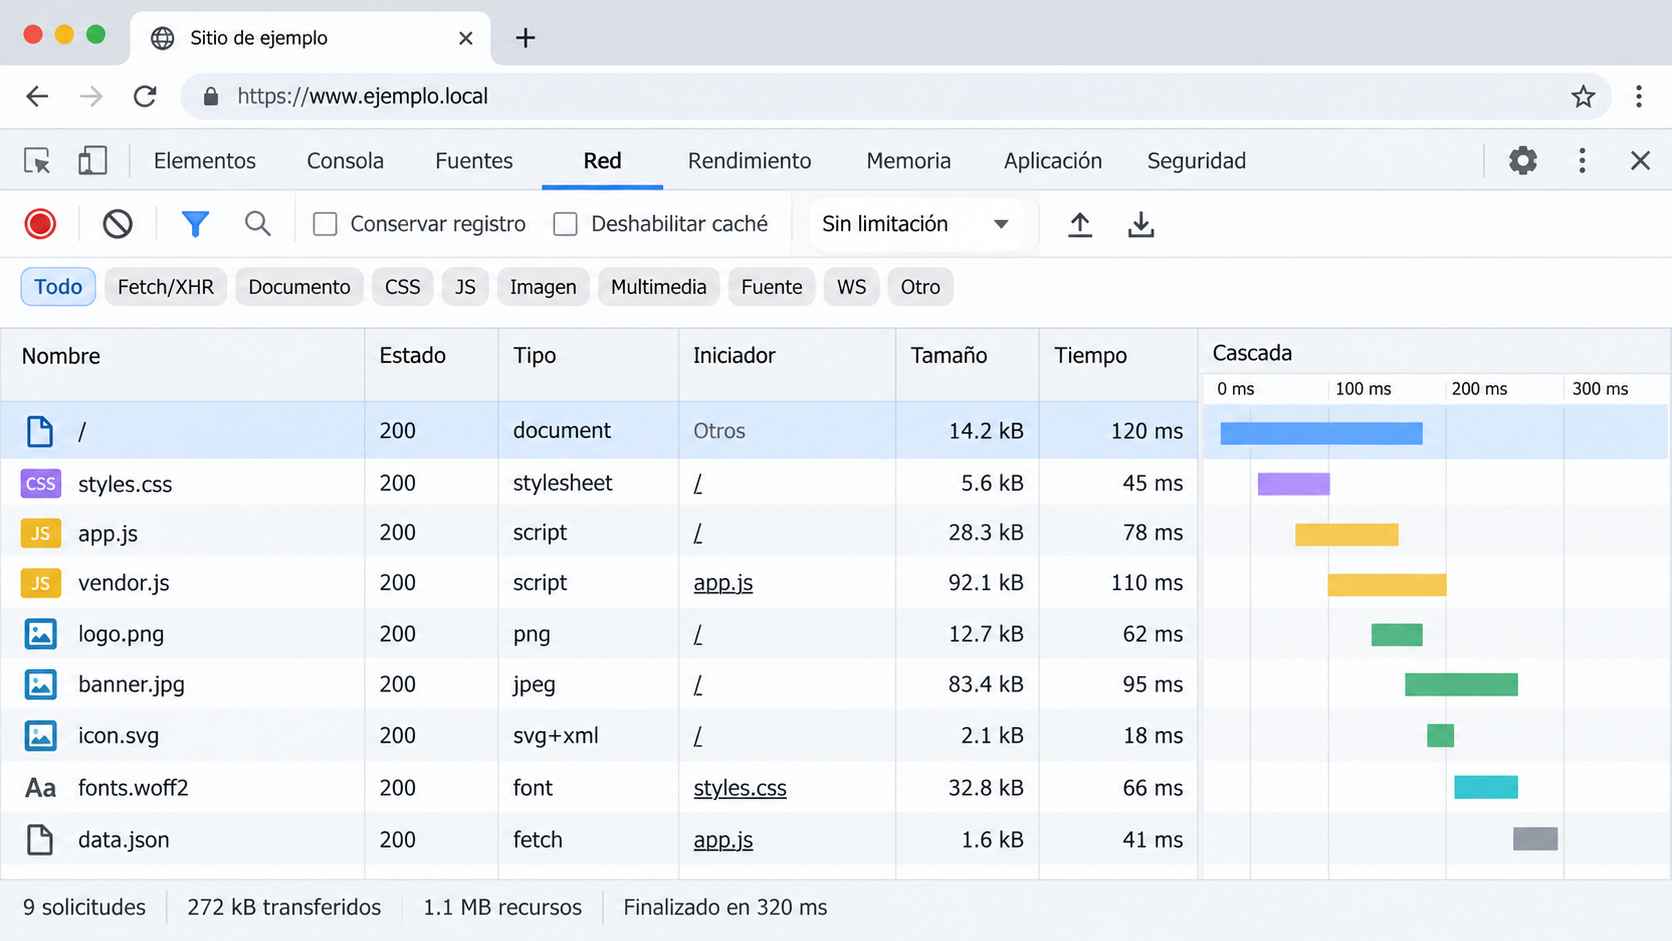
No necesitamos imaginar todo este intercambio. Los navegadores actuales incluyen herramientas de desarrollo que permiten observar las peticiones y respuestas HTTP.
Normalmente podemos abrir las Herramientas para desarrolladores y utilizar el panel Red / Network. Al seleccionar una petición podemos consultar información como:
- URL solicitada.
- Método HTTP.
- Código de estado.
- Cabeceras de petición.
- Cabeceras de respuesta.
- Tipo y tamaño del recurso.
- Protocolo utilizado, dependiendo del navegador.
Antes de continuar, comprueba que puedes responder estas preguntas:
- ¿Qué diferencia existe entre una petición y una respuesta HTTP?
- ¿Qué información podemos identificar en una URL?
- ¿Para qué sirve un método HTTP?
- ¿Qué nos indica la primera cifra de un código de estado?
- ¿Qué diferencia existe entre HTTP y HTTPS?
- ¿Por qué ya no es correcto afirmar que una conexión TCP se cierra necesariamente después de cada respuesta HTTP?
2.8. Para saber más
Si quieres ampliar algunos de los conceptos de este apartado, puedes consultar:
- Generalidades del protocolo HTTP — MDN.
- Mensajes HTTP — MDN.
- Evolución del protocolo HTTP — MDN.
- HTTP Semantics — RFC 9110, como referencia técnica oficial del protocolo.
Estos recursos son complementarios y no es necesario estudiarlos en profundidad para seguir la unidad.